Correlação espúria: como dado oficial produz relação absurda
Margarina e divórcios no Maine têm r de 0,99. Como o acaso e a tendência no tempo criam correlação sem causa, e como não cair nisso na sua planilha.
Tyler Vigen mantém uma base com 25.237 variáveis de dados públicos dos Estados Unidos e compara todas contra todas. São 636.906.169 cálculos de correlação. Nesse volume, achar pares quase idênticos não é surpresa: é certeza aritmética.
Um dos pares: o consumo de margarina per capita e a taxa de divórcio no Maine, de 2000 a 2009, com r de 0,9926. Os dados são oficiais e ninguém propõe cortar margarina para salvar casamentos.
Este texto mostra como esse tipo de correlação nasce e por que a mesma mecânica opera, em escala menor, na matriz de correlação da sua planilha de processo. Se você procura a diferença entre correlação e causalidade, comece por correlação não é causalidade.
Testar muitos pares produz coincidência por construção#
O autor do projeto é explícito sobre o que faz. Ele nomeia o método, data dredging, garimpo de dados, e adverte que qualquer conjunto suficientemente grande produz correlações fortes inteiramente ao acaso.
Alguns achados dessa máquina, todos com dado público real:
| Par de variáveis | r | Período |
|---|---|---|
| Consumo de margarina · divórcios no Maine | 0,9926 | 2000 a 2009 |
| Consumo de mozzarella · bacharéis em Engenharia | 0,9737 | 2012 a 2021 |
| Consumo de queijo · mortes por enredamento em lençol | 0,9471 | 2000 a 2009 |
| Filmes de Nicolas Cage · afogamentos em piscina | 0,6660 | 1999 a 2009 |
As duas primeiras linhas foram conferidas na página do próprio projeto. As duas últimas vêm da versão original de 2014, tal como reproduzida desde então, e não foi possível reabrir a página de origem delas. A distinção está detalhada nas fontes, no fim do texto.
O exemplo mais famoso da lista é o mais fraco de todos: o par do Nicolas Cage, que virou meme de apresentação, tem r de 0,67, contra 0,97 da mozzarella. A fama do exemplo não tem relação com a força do número.
O nome técnico do mecanismo é comparações múltiplas. Cada teste isolado tem chance pequena de produzir resultado forte por acaso; centenas de milhões de testes transformam essa chance pequena em ocorrência garantida.
O p-valor não resgata ninguém disso. O par da margarina tem p de 1,3 × 10⁻⁸, e significância responde "esse padrão seria raro por acaso neste teste", não "quantos testes você rodou antes de me mostrar este".
A mesma coisa, na escala de uma planilha#
Quem roda uma matriz de correlação com 20 variáveis de processo testa 190 pares de uma vez. Para ver o efeito, vale simular: 5.000 matrizes de 20 variáveis aleatórias, com 10 observações cada, sem nenhuma relação entre elas.
Em média, 4,7 dos 190 pares de cada matriz passam de 0,7 em valor absoluto. Em 99,3% das matrizes há pelo menos um. O número depende do tamanho da amostra: com 10 observações por variável, uma correlação alta sai fácil, e com centenas ela fica bem mais rara.
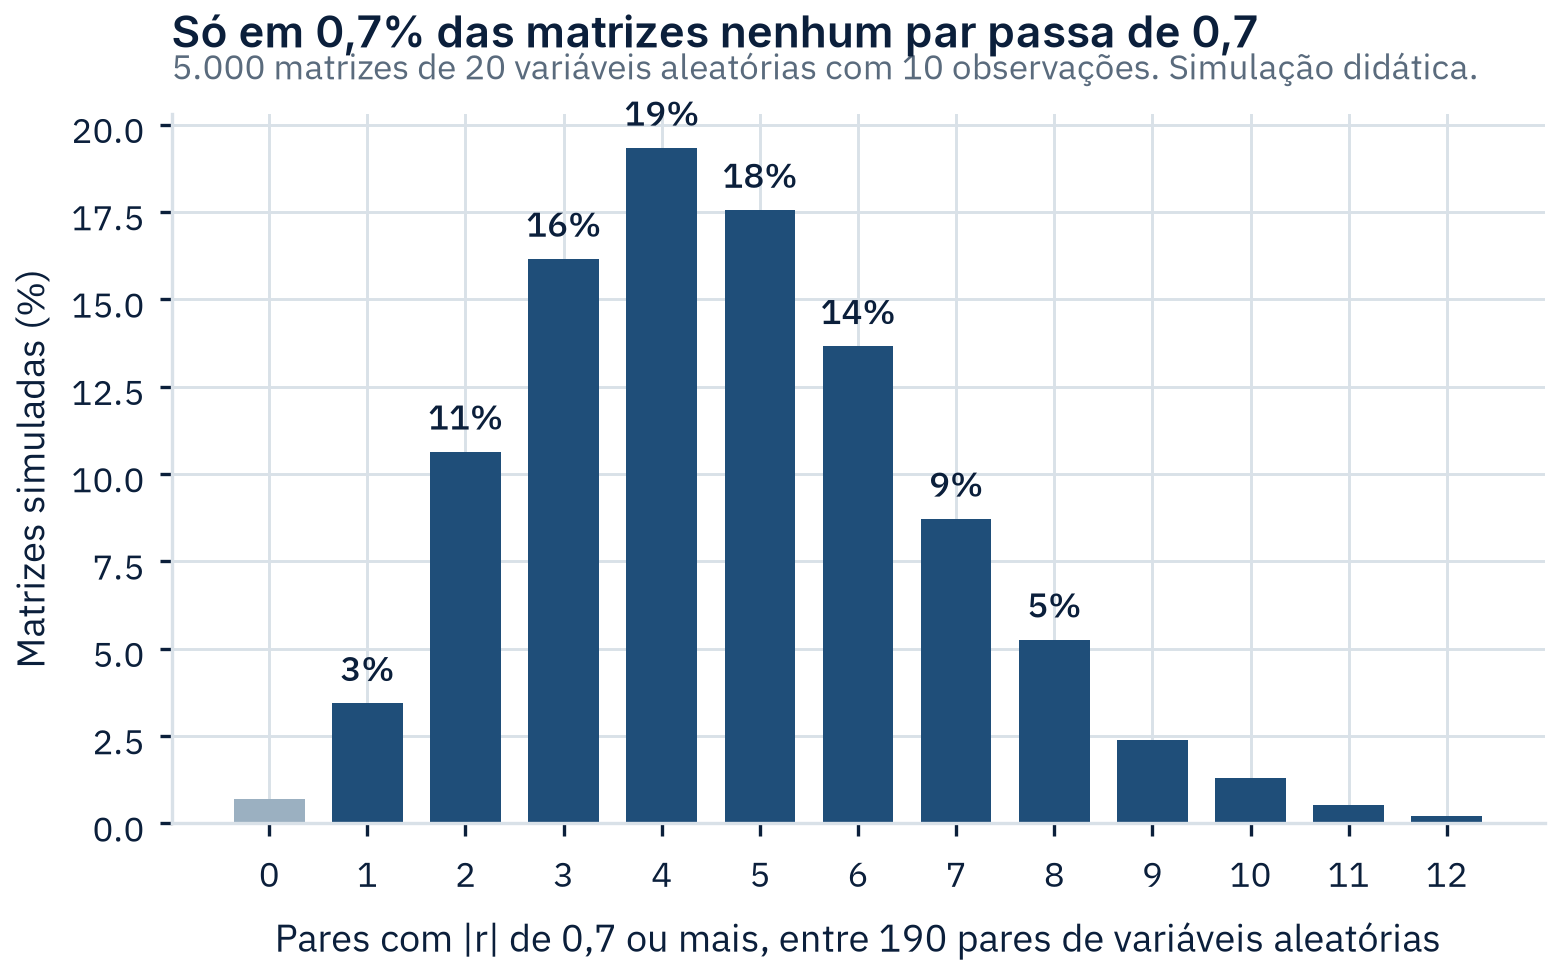
É por isso que matriz de correlação serve para triagem, nunca para conclusão. O par que se destaca é um suspeito a investigar, e a pergunta seguinte é sobre o mecanismo, não sobre o tamanho do r.
Séries que só crescem se correlacionam sem se tocar#
Existe uma segunda fonte de correlação falsa que não precisa de garimpo e é ainda mais comum em dado de negócio: a tendência compartilhada no tempo.
Pense em qualquer par de séries que cresceu nas últimas décadas: população, PIB, aparelhos celulares, consumo de energia. Compare duas quaisquer e o coeficiente sai alto, porque as duas são basicamente uma reta ascendente com detalhes em cima. Elas não estão relacionadas entre si; estão ambas indexadas ao tempo.
Dentro da empresa isso aparece com outra roupa. Volume produzido, horas trabalhadas, consumo de energia, custo total e quantidade de defeitos crescem juntos ao longo do ano porque a operação cresceu. Correlacionar duas dessas séries sem tirar o efeito do volume produz número alto e vazio.
Os doze meses do gráfico abaixo são construídos para ensino, com taxa de defeito de cerca de 2% em todos eles.
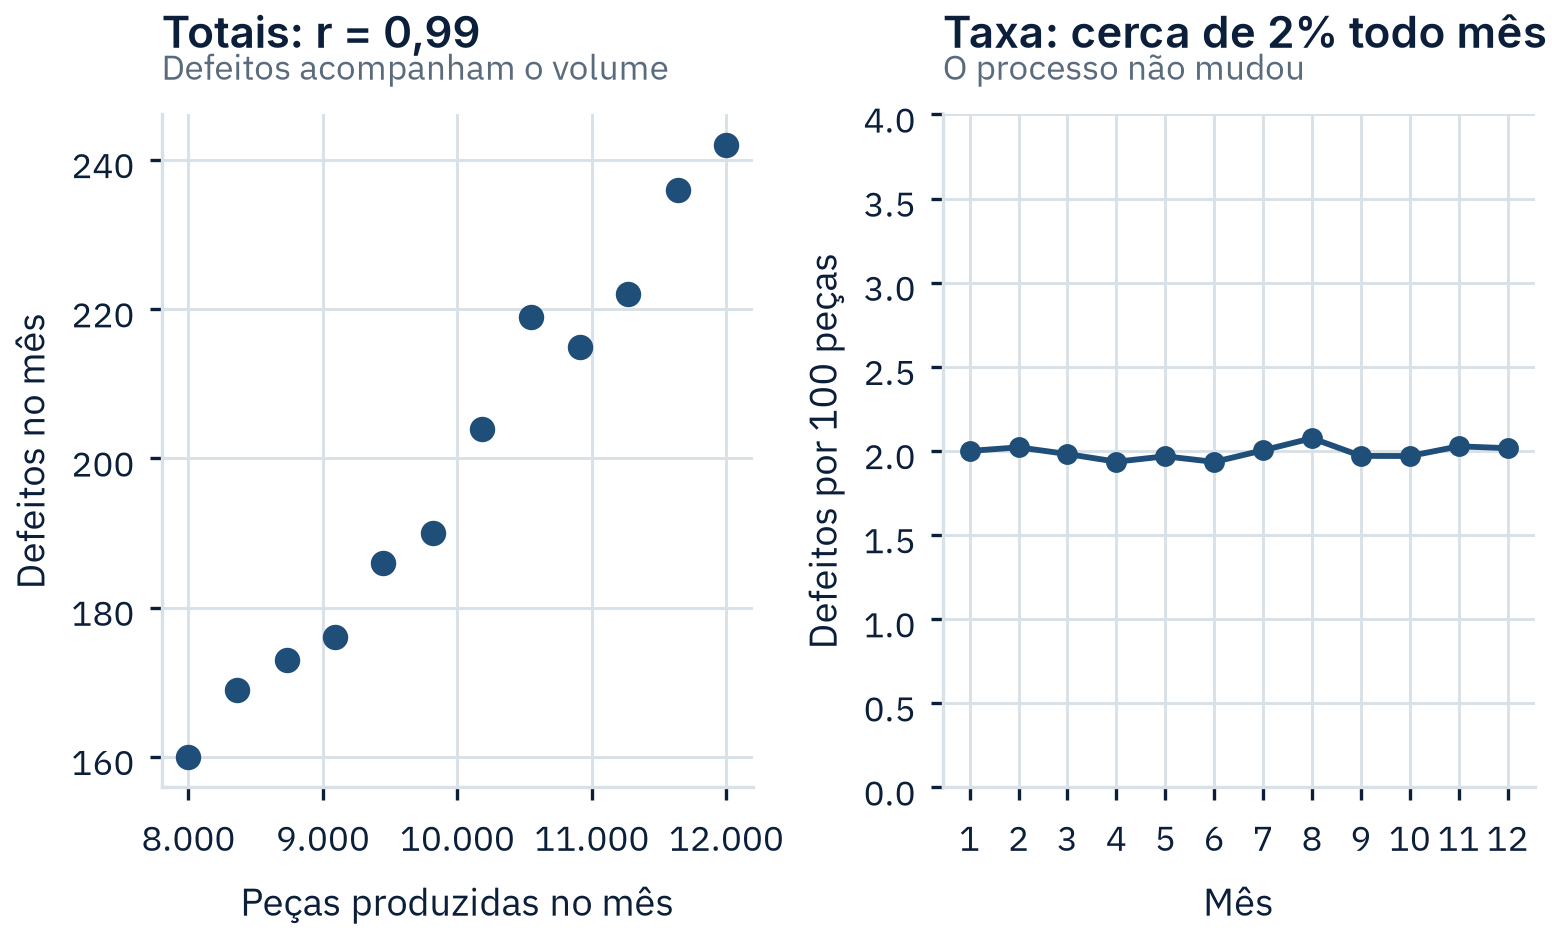
A defesa é comparar taxas, não totais, ou remover a tendência antes de comparar.
Onde isso não basta#
A simulação mostra o risco de sair procurando, não o tamanho dele na sua planilha. Com mais observações por variável, correlação forte ao acaso fica mais rara, mas quem testa muitos pares ainda encontra alguns.
E o inverso também vale: um par que sobreviveu a um teste honesto, com poucas variáveis e amostra grande, pode ser real. A matriz não decide nenhum dos dois casos; o mecanismo e a repetição decidem.
Três defesas antes de confiar numa matriz de correlação#
- Conte os pares. Uma matriz com 20 variáveis testa 190 combinações, e algumas vão se destacar por acaso. Quanto mais variáveis, mais pares, e mais coincidências.
- Compare taxas, não totais. Se as duas séries crescem com o volume, a correlação mede o volume.
- Peça o mecanismo. Para o par que sobrar, descreva a cadeia física que liga X a Y antes de agir, e só então decida se vale um teste ou um experimento.
Pegue hoje a correlação mais forte da sua planilha e responda a essas três perguntas, como se ela fosse a margarina do Maine. Se sobreviver, as sete perguntas que separam suspeito de causa são o passo seguinte.
Fontes dos números citados#
Os números sobre a base de Vigen foram conferidos em 26 de setembro de 2026, e vale separar o que foi lido na fonte do que veio de reprodução.
- Spurious Correlations, de Tyler Vigen (tylervigen.com), publicado em 2014. Conferidos na página do projeto: margarina e divórcios no Maine, com r = 0,9925585, p = 1,3 × 10⁻⁸, 2000 a 2009, séries do US Department of Agriculture e do CDC National Vital Statistics; mozzarella e bacharéis em Engenharia, com r = 0,9736573, p = 2,041 × 10⁻⁶, 2012 a 2021, séries do USDA e do National Center for Education Statistics; e a escala do garimpo, 25.237 variáveis e 636.906.169 cálculos, declarada pelo autor na página de metodologia. Não conferidos na fonte: queijo e mortes por enredamento em lençol (r = 0,947091) e filmes de Nicolas Cage e afogamentos em piscina (r = 0,666004) são da versão original de 2014, cuja página não foi possível reabrir; ambos são amplamente reproduzidos, o primeiro em periódico revisado por pares, citado abaixo.
- HRABAČ, P.; TRKULJA, V. Of cheese and bedsheets: some notes on correlation. Croatian Medical Journal, v. 61, n. 3, p. 293 a 295, 2020.
- KRULWICH, R. Nick Cage Movies vs. Drownings, and More Strange (but Spurious) Correlations. National Geographic, 11 de setembro de 2015.
Perguntas frequentes
O que é uma correlação espúria?
É uma associação estatística forte entre duas variáveis sem ligação causal. Aparece por acaso, principalmente quando se testam muitas combinações, ou porque as duas séries seguem uma tendência comum no tempo. O exemplo mais conhecido é a margarina e os divórcios no Maine, com r de 0,99 entre 2000 e 2009.
Por que testar muitas variáveis cria correlação forte por acaso?
Cada teste isolado tem pouca chance de dar resultado forte por acaso, mas centenas de testes tornam isso quase certo. Numa matriz de 20 variáveis há 190 pares, e numa simulação com dados aleatórios, em média 4,7 deles passam de 0,7. Por isso a matriz de correlação serve para triagem, nunca para conclusão.
Duas séries que crescem no tempo estão relacionadas?
Não necessariamente. Séries que só crescem, como produção, horas trabalhadas e defeitos, dão correlação alta porque ambas acompanham o tempo ou o volume. Compare taxas em vez de totais, ou remova a tendência antes de comparar.
Quem escreveu
Fernando Henrique Branco
Engenharia Industrial · Excelência Operacional · Estratégia Industrial
Começou como técnico de usinagem de precisão e operador de produção, e passou por laboratório, auditoria da qualidade e engenharia de processos antes de chegar à coordenação. Hoje é Coordenador de Engenharia Industrial na Docol, à frente de 19 profissionais que cobrem a cadeia completa de processos: fundição, injeção, usinagem, galvanoplastia, conformação, forjamento e montagem.
Leituras relacionadas
- ArtigoFMEA na prática: como antecipar falhas e priorizar ações de prevençãoEntenda o FMEA com um exemplo de montagem: modos de falha, causas, efeitos, NPR, Prioridade de Ação e verificação da eficácia das medidas adotadas no processo.
- ArtigoMédia boa não é processo estável: o erro que o gráfico de controle escondeDuas linhas podem fechar o mês com a mesma média e processos completamente diferentes. Como causa comum e causa especial decidem se um processo é estável.