
Correlação não é causalidade: o erro que faz a fábrica agir na variável errada
Duas variáveis andarem juntas não prova que uma causa a outra. As quatro estruturas por trás de uma correlação, e as perguntas que separam suspeito de causa.
Em 2014, um estudante de direito chamado Tyler Vigen colocou no ar um site que comparava séries de dados públicos dos Estados Unidos entre si. Uma das comparações mostrava o consumo de margarina per capita e a taxa de divórcio no estado do Maine, entre 2000 e 2009. As duas linhas caíram juntas, ano após ano, com uma sincronia quase perfeita: coeficiente de correlação de 0,9926, com r² de 0,985 e um p-valor de 1,3 × 10⁻⁸.
Esse resultado passa em todos os testes formais de um curso de estatística básica. A associação é fortíssima, é significativa com folga, e os dados são oficiais: margarina do Departamento de Agricultura americano, divórcios do sistema de estatísticas vitais do CDC. Nada foi inventado. E ninguém, em sã consciência, vai propor cortar margarina para salvar casamentos no Maine.
Esse é o ponto de partida, e ele é o fácil. O difícil vem depois: dentro de uma fábrica, as correlações enganosas não são absurdas. Elas são plausíveis, defendidas por gente competente em reunião, e é por isso que viram projeto, viram CAPEX e viram plano de ação contra a variável errada.
Correlação mede se duas variáveis andam juntas, e só isso#
Correlação mede quanto duas variáveis tendem a se mover em conjunto. É descrição de comportamento observado, não explicação.
Ela tem direção. Na associação positiva, as duas sobem juntas: mais rotação, mais temperatura. Na associação negativa, uma sobe enquanto a outra desce: mais velocidade de linha, menos tempo de ciclo por peça. E tem intensidade: a nuvem de pontos pode ser apertada em torno de uma tendência, ou tão espalhada que a tendência quase desaparece dentro dela.
O instrumento que resume as duas coisas num número só é o coeficiente de correlação de Pearson, o famoso r, que varia de -1 a +1. Perto de +1, associação linear positiva forte. Perto de -1, negativa forte. Perto de 0, pouca ou nenhuma associação linear.
Essa última palavra carrega o peso da frase inteira.
O coeficiente r resume a força e esconde a forma#
Um r próximo de zero não significa ausência de relação. Significa ausência de relação em linha reta, que é a única coisa que o coeficiente de Pearson sabe procurar.
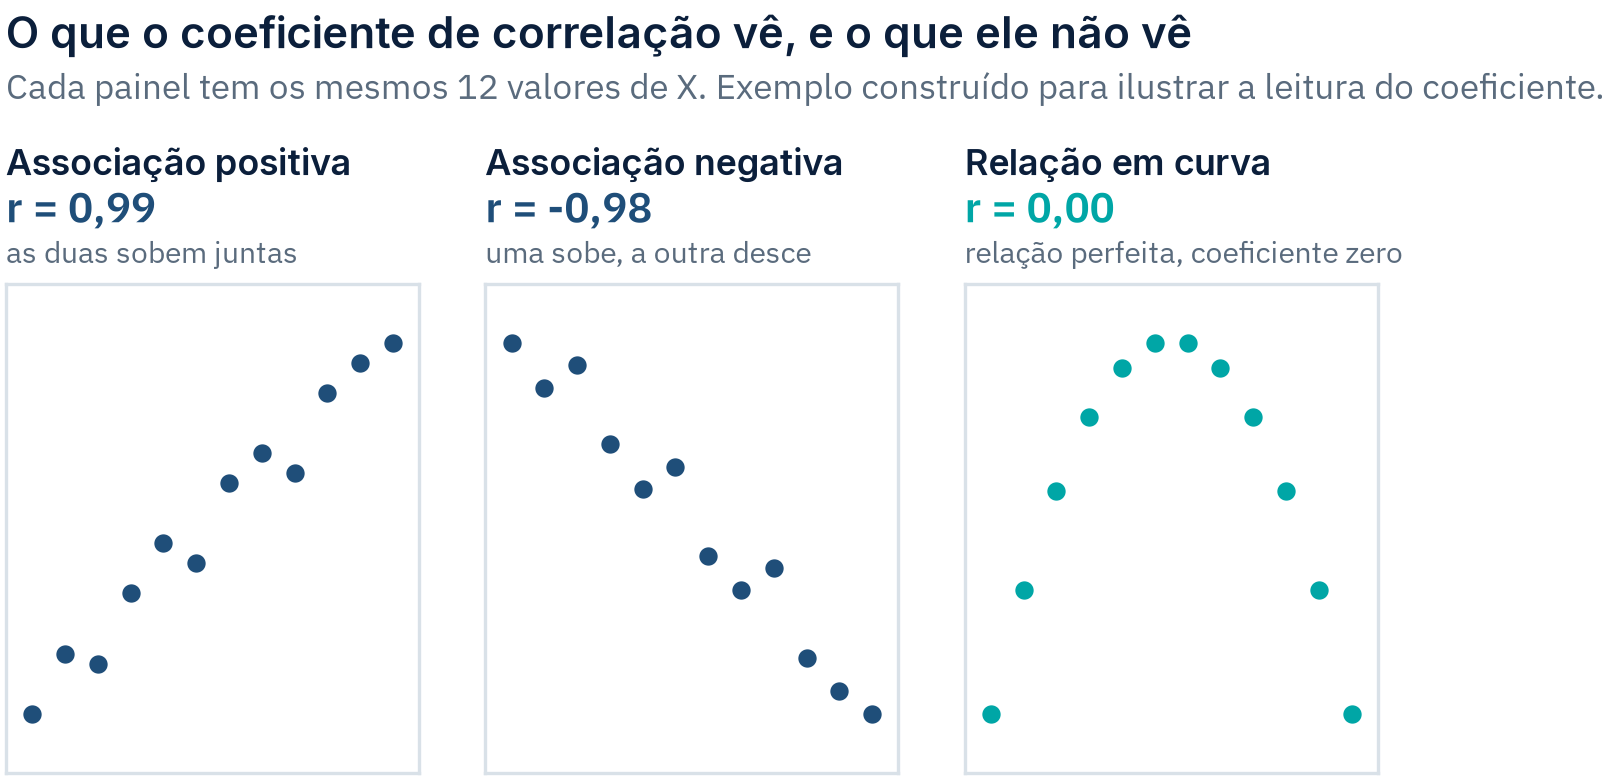
No terceiro painel, cada valor de Y sai de X por uma fórmula exata. Não há ruído nem dispersão: a relação é perfeita. E o coeficiente dá zero, porque a curva sobe e depois desce, e o que sobe cancela o que desce na conta.
Isso tem consequência direta em processo. Muita relação de engenharia é curva por natureza: rendimento que melhora com a temperatura até um ponto e piora depois, dureza que satura, desgaste que acelera. Descartar uma variável porque "a correlação deu 0,05" é erro de planilha de projeto, não de estatística.
A defesa custa dez segundos: olhe o gráfico de dispersão antes de calcular o coeficiente, nunca depois. O argumento definitivo é de 1973, quando o estatístico Francis Anscombe publicou quatro conjuntos com média, variância, correlação e reta de regressão praticamente idênticas e comportamentos completamente diferentes: um linear com ruído, um em curva, um com a reta estragada por um único ponto fora e um com a correlação inteira produzida por uma única observação. Os quatro geram o mesmo relatório, e três das quatro conclusões seriam falsas.
r igual a 0,95 não é 95% de chance de X causar Y#
Duas leituras erradas do coeficiente circulam com naturalidade em apresentação de resultado.
A primeira: r não é probabilidade. Um r de 0,95 não quer dizer "95% de chance de que X cause Y". Não há leitura de causa embutida no coeficiente, em nenhum valor dele.
A segunda: r não é a proporção de Y explicada por X. Essa é r², e a diferença não é acadêmica:
| Coeficiente r | Leitura habitual | Variação associada (r²) |
|---|---|---|
| 0,95 | muito forte | 90% |
| 0,80 | muito forte | 64% |
| 0,60 | forte | 36% |
| 0,40 | moderada | 16% |
Uma correlação de 0,60, que quase todo relatório descreve como forte, está associada a 36% da variação. Os outros 64% vêm de outro lugar. Reportar r² ao lado de r é o hábito mais barato para evitar essa superestimação silenciosa.
E nem o r² fala de causa. O caso da margarina tinha r² de 0,985: 98,5% da variação de uma série acompanhada pela outra, sem que uma tivesse qualquer efeito sobre a outra.
Correlação pergunta se andam juntas; causalidade, se mexer muda#
Aqui está a distinção que sustenta o artigo inteiro.
Correlação responde: quando X muda, Y costuma mudar junto?
Causalidade responde: se eu intervier deliberadamente em X, isso vai provocar uma mudança em Y?
A primeira se responde olhando. A segunda se responde mexendo, ou, quando não dá para mexer, reunindo evidência suficiente para que mexer seja aposta defensável.
E existe um terceiro elemento, que é o que separa uma afirmação de engenharia de uma afirmação de planilha: o mecanismo. Quem diz que a temperatura do molde causa o refugo está afirmando uma cadeia física. A temperatura altera a taxa de resfriamento, que altera a contração, que altera a cota, que estoura a especificação. Cada elo é verificável em separado.
Se ninguém na sala consegue descrever essa cadeia, o que existe é uma associação com um responsável nomeado por conveniência. Não é nem errado, necessariamente. É que ainda não é conhecimento.
Quatro estruturas produzem a mesma correlação, e só uma é causa#
Esta é a parte que mais muda a forma de ler dado, e costuma ser pulada. Quando X e Y aparecem associados, há quatro explicações estruturalmente diferentes, e o dado observacional sozinho não distingue entre elas.
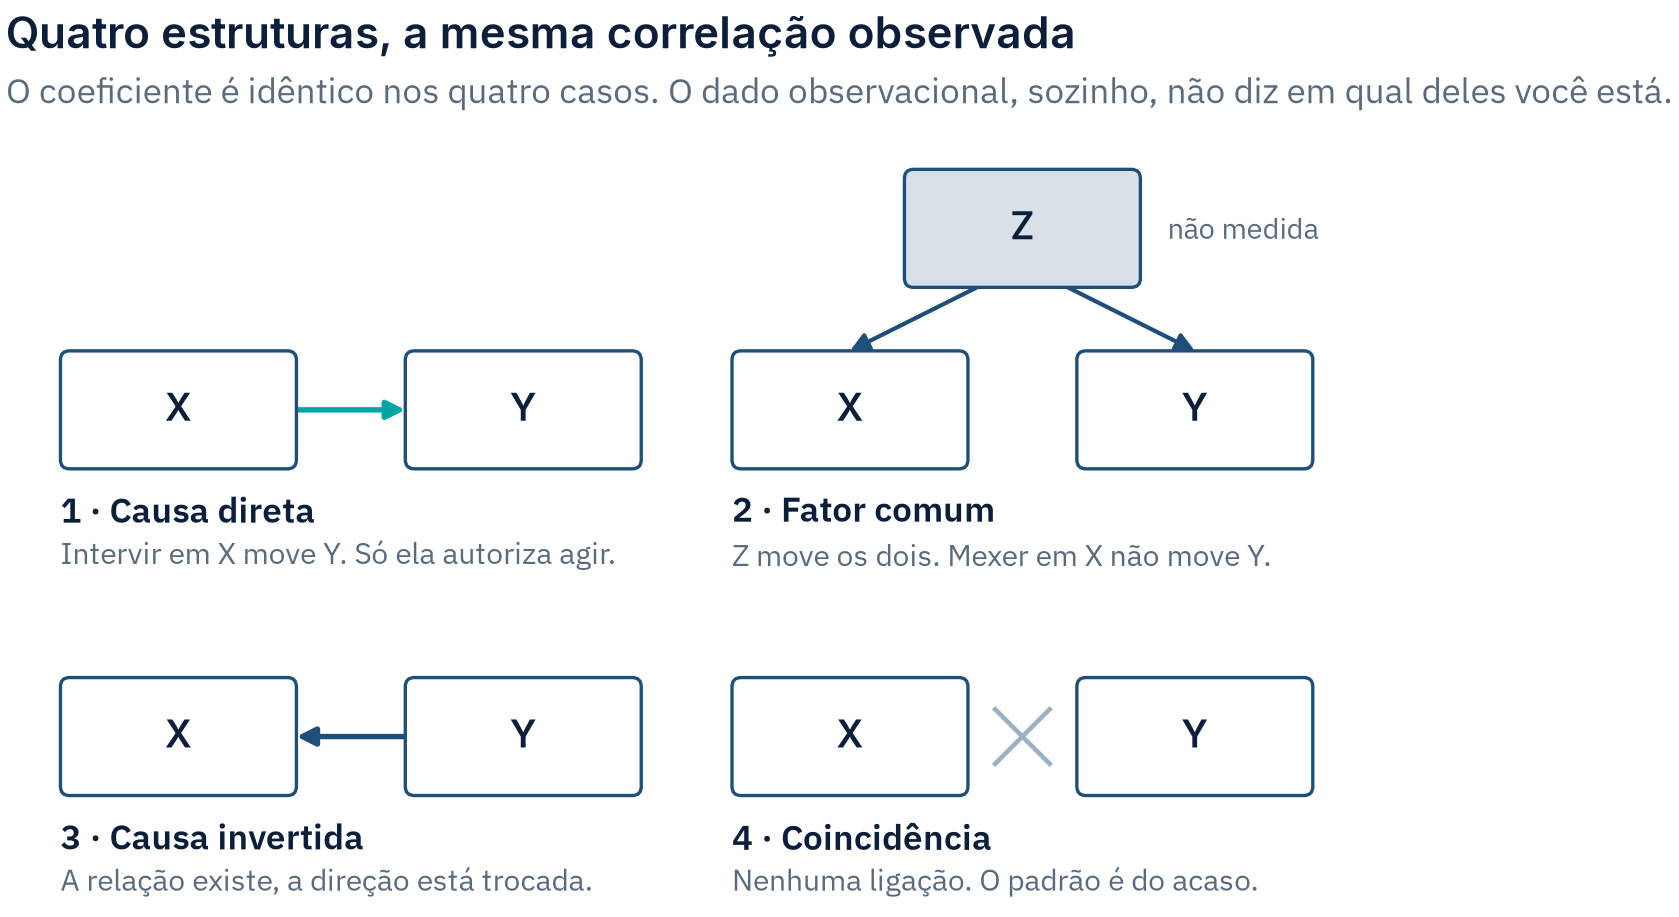
A consequência prática de cada uma é bem diferente:
| Estrutura | O que está acontecendo | Se você agir em X |
|---|---|---|
| Causa direta | X provoca Y por um mecanismo | Y muda. É o único caso em que a ação funciona |
| Fator comum | Z move X e Y ao mesmo tempo | nada acontece com Y, e o custo foi gasto |
| Causa invertida | na verdade Y provoca X | nada acontece, e o diagnóstico fica pior |
| Coincidência | não há ligação nenhuma | nada acontece, e a confiança no método cai |
Três das quatro estruturas levam a uma ação que não produz efeito. É por isso que a pergunta "qual é o mecanismo?" não é preciosismo acadêmico: é o filtro mais barato antes de aprovar um plano de ação.
Sorvete e ataque de tubarão: um terceiro fator explica os dois#
O exemplo didático mais conhecido de variável de confusão (confounding variable) é o consumo de sorvete contra o número de ataques de tubarão. Os dois sobem juntos com regularidade impressionante.
Quando a temperatura sobe, mais gente compra sorvete e mais gente entra no mar. Mais gente na água é mais exposição, e mais exposição é mais encontros com tubarão. A temperatura, e o verão que vem com ela, empurra as duas variáveis de forma independente. Cortar o sorvete não reduz um único ataque. É a segunda estrutura do diagrama: Z move X e Y, e X e Y não se tocam.
Na fábrica o confundidor raramente é o clima. Ele costuma ser demanda, mix de produto, turno, máquina ou lote de matéria-prima, e é aí que mora a diferença entre este exemplo e o seu problema real: sorvete e tubarão é óbvio, demanda e defeito não é.
Manutenção e falha: a direção da causa também se erra#
A terceira estrutura é a causalidade reversa (reverse causality), traiçoeira porque a relação realmente existe. O erro não é ver conexão onde não há, é ler a seta ao contrário.
Fora da indústria o exemplo é direto: quem toma mais remédio adoece mais, e ninguém conclui que o remédio adoece. A doença é que produz a necessidade do remédio.
Dentro da fábrica, o caso equivalente aparece em relatório de confiabilidade: os equipamentos que mais recebem intervenção de manutenção são os que mais apresentam falha. A leitura apressada é constrangedora e acontece: "quanto mais a manutenção mexe, mais quebra".
Há pelo menos duas explicações melhores, e as duas invertem ou dissolvem a seta. Máquinas problemáticas atraem intervenção justamente por falharem mais, e aí a falha é a causa da manutenção. Ou existe um fator comum por trás das duas, como criticidade do ativo, idade ou severidade da aplicação, que produz ao mesmo tempo mais falha e mais atenção.
Distinguir entre elas muda a decisão inteira. Se for causa invertida, o plano é de confiabilidade do ativo. Se for fator comum, é de política de uso. E se alguém acreditar na leitura literal, o plano vira cortar preventiva, que é a pior das três saídas.
Testar 636 milhões de pares produz coincidência por construção#
Falta explicar por que a margarina do começo existe, e essa é a parte mais útil do artigo para quem trabalha com dado de processo, porque o mecanismo é o mesmo em escala menor.
O autor do projeto é explícito sobre o que faz: mantém 25.237 variáveis na base e compara todas contra todas, o que dá 636.906.169 cálculos de correlação. Nesse volume, achar pares quase idênticos deixa de ser surpresa e vira certeza aritmética. Ele mesmo nomeia o método, data dredging, garimpo de dados, e adverte que qualquer conjunto suficientemente grande produz correlações fortes inteiramente ao acaso.
Alguns achados dessa máquina, todos com dado público real:
| Par de variáveis | r | Período |
|---|---|---|
| Consumo de margarina · divórcios no Maine | 0,9926 | 2000 a 2009 |
| Consumo de mozzarella · bacharéis em Engenharia | 0,9737 | 2012 a 2021 |
| Consumo de queijo · mortes por enredamento em lençol | 0,9471 | 2000 a 2009 |
| Filmes de Nicolas Cage · afogamentos em piscina | 0,6660 | 1999 a 2009 |
As duas primeiras linhas foram conferidas na página do próprio projeto; as duas últimas vêm da versão original de 2014, tal como reproduzida desde então, e não foi possível reabrir a página de origem delas. A distinção está detalhada no fim do artigo.
Duas coisas valem nessa tabela. A segunda linha responde à pergunta de quem quer formar mais engenheiro subsidiando pizza. E o exemplo mais famoso da lista é o mais fraco de todos: o par do Nicolas Cage, que virou meme de apresentação, tem r de 0,67, contra 0,97 da mozzarella. A fama do exemplo não tem relação com a força do número.
O nome técnico do mecanismo é comparações múltiplas. Cada teste isolado tem chance pequena de produzir resultado forte por acaso; centenas de milhões de testes transformam essa chance pequena em ocorrência garantida. Quem roda uma matriz de correlação com 20 variáveis de processo está testando 190 pares de uma vez, com o mesmo efeito operando em miniatura. É por isso que matriz de correlação serve para triagem, nunca para conclusão.
E o p-valor não resgata ninguém disso: o par da margarina tem p de 1,3 × 10⁻⁸. Significância responde "esse padrão seria raro por acaso neste teste", e não responde "quantos testes você rodou antes de me mostrar este".
Duas séries que só crescem no tempo se correlacionam sem se tocar#
Existe uma segunda fonte de correlação falsa que não precisa de garimpo, e é ainda mais comum em dado de negócio: a tendência temporal compartilhada.
Pense em qualquer par de séries que cresceu nas últimas décadas: população, PIB, aparelhos celulares, consumo de energia, produção de alimentos. Compare duas quaisquer e o coeficiente sai alto, porque as duas são basicamente uma reta ascendente com detalhes em cima. Elas não estão relacionadas entre si; estão ambas indexadas ao tempo.
Dentro da empresa isso aparece com outra roupa. Volume produzido, horas trabalhadas, consumo de energia, número de apontamentos, custo total e quantidade de defeitos crescem juntos ao longo do ano porque a operação cresceu. Correlacionar duas dessas séries sem tirar o efeito do volume produz número alto e vazio.
A defesa é a mesma em todos os casos: compare taxas, não totais, ou remova a tendência antes de comparar. É o assunto do próximo bloco, e é o erro industrial número um da lista.
Na fábrica, a correlação enganosa é plausível, e é por isso que passa#
Nenhum dos quatro casos a seguir é absurdo. Todos já foram defendidos com convicção em sala de reunião, e é essa plausibilidade que os torna caros.
Produzir mais causa mais defeito? Nos dias de maior produção aparecem mais defeitos, e a correlação é forte. Veja o que acontece com uma taxa de falha rigorosamente constante de 2%:
| Peças produzidas no dia | Taxa de falha | Defeitos no dia |
|---|---|---|
| 1.000 | 2% | 20 |
| 10.000 | 2% | 200 |
O número absoluto de defeitos cresce dez vezes e a qualidade do processo não mudou uma vírgula. A correlação é real, é forte e é aritmética: os dois são contagens do mesmo denominador. Trocar a contagem pela taxa faz a relação inteira desaparecer. Escolher a métrica errada é a forma mais barata de produzir correlação enganosa, e não precisa de acaso nenhum.
Hora extra causa defeito? Aqui a correlação é real e o mecanismo é plausível: fadiga degrada atenção, atenção degrada execução. Pode ser causa direta. Só que hora extra quase nunca chega sozinha: ela vem de demanda elevada, que traz junto cadência acelerada, setup apressado, manutenção postergada e pressão para liberar lote no limite. A correlação identificou uma janela de tempo em que o processo piora, não identificou por quê. Tratar a hora extra como causa produz um plano que limita jornada e não toca em nenhum dos outros quatro fatores.
Inspecionar causa defeito? As linhas com mais inspeção registram mais defeitos. Aqui a estrutura não é nenhuma das quatro na forma pura: é problema de medição, não de processo. A inspeção não cria defeito, muda a probabilidade de detectar o que já existia. Uma linha com pouca inspeção e poucos defeitos registrados pode ser apenas uma linha que não enxerga o que produz, e esse é o pior desfecho possível: o defeito que ninguém registra é o que chega ao cliente.
Manutenção causa falha? É o caso da seção anterior, e fecha a lista das quatro armadilhas: métrica mal escolhida, fator comum, artefato de medição e direção invertida.
A estratificação pode inverter o sinal da conclusão#
Se houvesse uma única técnica para levar deste artigo para a próxima análise, seria esta. Quando os dados agregam subgrupos com comportamentos distintos, a relação observada no conjunto pode ser oposta à que existe dentro de cada subgrupo. O fenômeno tem nome, paradoxo de Simpson, e não é raro em dado industrial.
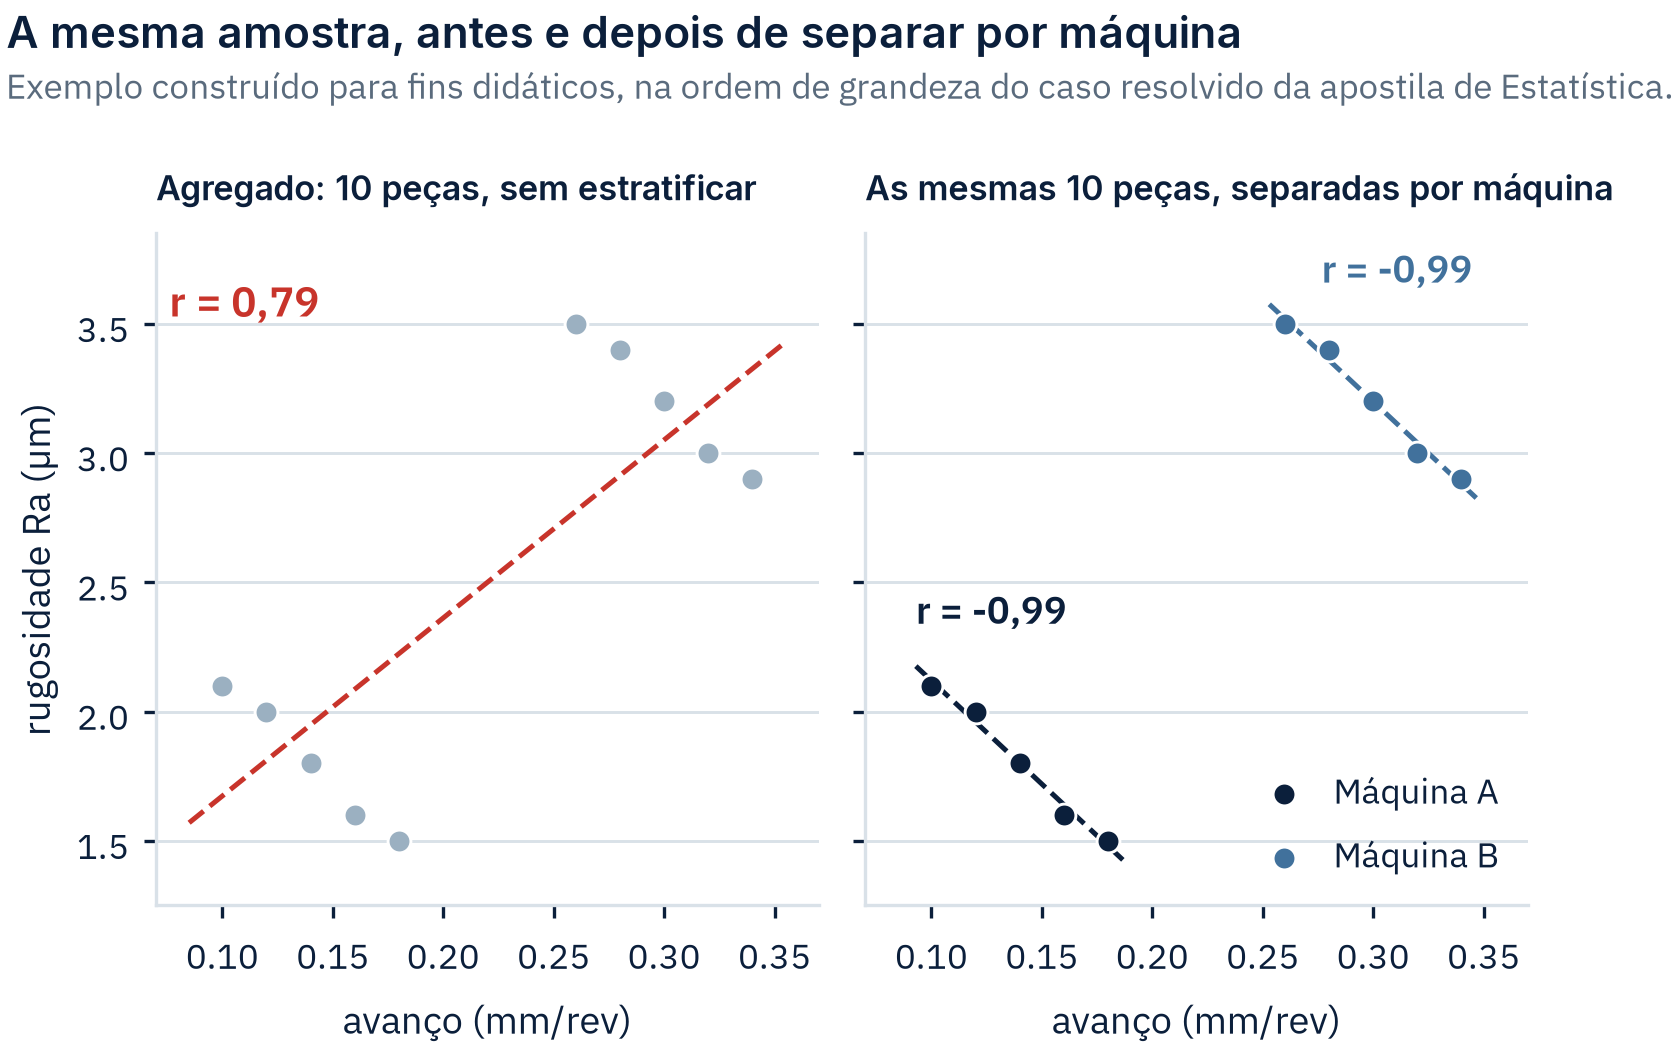
O exemplo é construído para fins didáticos, na ordem de grandeza do caso resolvido da apostila de Estatística da FX. Uma análise de peças usinadas indica correlação positiva entre velocidade de avanço e rugosidade superficial, com r de 0,79: quanto maior o avanço, pior o acabamento. A conclusão é tecnicamente coerente, casa com o que todo mundo aprendeu, e um projeto é aberto para reduzir o avanço.
Aí alguém separa os dados por máquina. A máquina A opera com avanço baixo e entrega rugosidade média de 1,8 µm; a máquina B opera com avanço alto e entrega 3,2 µm. E dentro de cada uma, a correlação é negativa, com r de -0,99: aumentar o avanço melhora o acabamento. A correlação positiva do agregado vinha inteiramente do fato de a máquina B, que produz pior acabamento por razões próprias, operar com avanço mais alto. O confundidor era a máquina, e o projeto aprovado teria piorado a rugosidade nas duas.
A regra que sai daí cabe numa linha: sempre que houver fator registrado, como máquina, turno, cavidade, molde, fornecedor ou lote, plote o gráfico colorido por esse fator antes de concluir qualquer coisa.
O erro espelhado: faixa estreita esconde relação física forte#
Vale registrar o erro contrário, menos discutido e igualmente caro.
Um processo mantido rigorosamente sob controle produz dados com pouca variação, e correlação precisa de variação para aparecer. Se a temperatura ficou entre 178 °C e 182 °C durante toda a coleta, a correlação com a característica de saída vai sair baixa mesmo que a relação física seja forte e real. Não houve variação suficiente para revelá-la.
Concluir que "a temperatura não influencia" a partir desses dados é erro grave, e ele tem cara de rigor: o número está lá, a amostra é grande, a planilha está certa. O que está errado é a inferência.
A saída é variar o fator de propósito, dentro da faixa segura, e observar a resposta. Ou seja: quando o dado histórico não tem variação, a resposta não está no histórico, e o instrumento passa a ser o experimento planejado.
Correlação encontra suspeitos, causalidade encontra os X críticos#
Traduzindo tudo isso para a forma como um problema de processo é estruturado: todo resultado medido é função de um conjunto de entradas, o que se escreve como Y = f(X), a equação que separa a variável crítica do ruído. O trabalho de engenharia é dizer quais X, entre as dezenas candidatas, realmente governam o Y.
A analogia que ajuda a fixar o papel de cada coisa: correlação encontra suspeitos, causalidade encontra os X críticos. É analogia, não definição, e tem limite: um suspeito inocentado continua sendo informação útil, enquanto um X descartado cedo demais some do mapa e não volta.
O que ela transmite bem é que uma variável correlacionada com o Y pode ser seis coisas diferentes, e vale conferir a lista antes de nomear culpado:
- Causa, com mecanismo que se descreve e se testa.
- Consequência do próprio Y, com a seta invertida.
- Proxy de outra coisa: não age, apenas acompanha quem age.
- Variável de confusão, que move o Y e a candidata ao mesmo tempo.
- Coincidência, principalmente se veio de uma varredura de muitas variáveis.
- Artefato da seleção dos dados, como o caso da inspeção ou da janela escolhida.
Registrar essa lista enquanto a investigação está aberta é o papel do mapa de raciocínio, que guarda as teorias consideradas antes de a ferramenta ser escolhida. Sem ele, a primeira hipótese plausível vira conclusão por falta de concorrência.
Existe também o caminho inverso, percorrido antes de haver dado para correlacionar: o FMEA parte do requisito e trabalha para frente, da causa plausível ao modo de falha e ao efeito, enquanto a análise de correlação parte do resultado observado e trabalha para trás. As duas terminam na mesma exigência. Uma cadeia de falha escrita num formulário é hipótese, do mesmo jeito que um coeficiente alto é hipótese, e as duas só autorizam intervenção depois que o mecanismo foi verificado no processo real.
Sete perguntas antes de chamar X de causa#
Não existe teste único que estabeleça causalidade. O que existe é acúmulo de evidência em frentes independentes, e a formulação mais conhecida disso é de 1965, do epidemiologista Austin Bradford Hill, que propôs um conjunto de pontos de vista para julgar quando uma associação pode ser lida como causal. A lista abaixo adapta esse raciocínio para chão de fábrica.
Encontrou uma correlação forte? Antes de chamar de causa, responda:
- X aconteceu antes de Y? A causa precede o efeito. Parece óbvio, e cai por terra na primeira vez em que os dois vêm do mesmo apontamento de fim de turno, sem hora.
- Existe mecanismo plausível? Descreva a cadeia física, química, mecânica ou operacional que liga X a Y. Se ninguém consegue descrevê-la, a hipótese continua aberta, não confirmada.
- A relação sobrevive à estratificação? Separe por máquina, turno, molde, produto, lote, operador. Se o efeito some quando você controla um desses, o candidato era proxy do fator controlado.
- A relação se repete? Outro período, outro equipamento, outra planta, outra família de produto. Achado que não replica é achado de amostra, não do processo.
- Existe relação dose-resposta? Se um pouco mais de X produz um pouco mais de Y, e muito mais de X produz muito mais de Y, a hipótese ganha peso. Nem toda relação real é assim, porque há limiar e saturação, mas quando aparece, vale muito.
- Dá para intervir em X? Se você mexer de propósito, o Y responde? Esta é a pergunta que separa correlação de causa, e é a única que responde sozinha.
- A relação se sustenta no processo real? Vá ver. É o mesmo princípio de ir ao Genba e olhar o objeto real antes de aceitar a explicação: dado é registro do que aconteceu, e quem faz a peça costuma saber de um fator que não está em coluna nenhuma da planilha.
A sexta é a mais forte e tem instrumento próprio. Quando o histórico não basta, o caminho é provocar o processo de forma controlada: delineamento de experimentos (DOE) na indústria, teste A/B em ambiente digital, experimento natural ou análise quase-experimental quando a intervenção deliberada não é possível.
Dito isso, sem romantismo: dado observacional é excelente para gerar hipótese e ruim para confirmá-la, e é com dado observacional que a maior parte das decisões industriais acaba sendo tomada. Saber disso não impede de decidir. Impede de decidir achando que há mais certeza do que existe.
Onde isso não basta: quando não dá para experimentar#
Este artigo seria desonesto se terminasse mandando todo mundo rodar um DOE. Em muita situação real o experimento é inviável por razão legítima: o processo é contínuo e não para, a variação proposital produziria refugo caro ou risco de segurança, o cliente não aceita desvio de parâmetro validado, ou a variável simplesmente não é manipulável, como composição de matéria-prima recebida ou temperatura ambiente.
Quando é esse o caso, a resposta não é fingir que a correlação virou causa. É declarar o grau de evidência que você tem e agir em proporção a ele. Na prática:
- Trate a hipótese como hipótese, com dono e prazo, não como conclusão.
- Prefira a ação reversível e barata que testa a hipótese de graça ao investimento que só se justifica se ela estiver certa.
- Use a janela que o processo já oferece: parada programada, troca de lote, partida de turno, mudança de mix. São experimentos naturais que acontecem sem você pedir, desde que alguém esteja medindo na hora.
- Confira antes se o processo está estável, porque média boa não é a mesma coisa que processo estável, e correlação calculada sobre processo instável mistura dois regimes no mesmo coeficiente.
E há a situação em que a evidência é fraca, a decisão é urgente e alguém precisa decidir assim mesmo. Isso é legítimo. O que não é legítimo é registrar em ata que a causa raiz foi identificada.
O número impressiona; o mecanismo decide#
Uma correlação de 0,99 parece impossível de ignorar. Mas quando as variáveis são consumo de margarina e taxa de divórcio no Maine, fica evidente que um número impressionante não substitui uma explicação causal. O coeficiente nunca esteve errado: ele respondeu com precisão a pergunta que foi feita, e a pergunta era outra.
Num processo industrial as relações não serão absurdas assim, e é exatamente aí que mora o perigo. Hora extra e defeito fazem sentido juntos. Manutenção e falha fazem sentido juntos. Produção e refugo fazem sentido juntos. Nenhum provoca o riso que a margarina provoca, e por isso nenhum recebe a segunda pergunta. A mudança de hábito cabe numa frase dita em voz alta na próxima reunião de análise: antes de chamar isso de causa, qual é o mecanismo que liga X a Y?
Um coeficiente de correlação pode apontar onde investigar. Só a evidência causal deve determinar onde agir.
Se você tem uma análise aberta agora, pegue a correlação mais forte da planilha e rode as sete perguntas contra ela, em ordem. Na maioria dos casos ela cai na terceira, quando os dados forem estratificados por máquina ou por turno. Quando sobreviver às sete, você tem mais do que um suspeito.
Fontes dos números citados#
Os números deste artigo foram conferidos em 26 de setembro de 2026, e vale separar o que foi lido na fonte do que veio de reprodução.
- Spurious Correlations, de Tyler Vigen (tylervigen.com), publicado em 2014. Conferidos na página do projeto: margarina e divórcios no Maine, com r = 0,9925585, r² = 0,9851723, p = 1,3 × 10⁻⁸, 2000 a 2009, séries do US Department of Agriculture e do CDC National Vital Statistics; mozzarella e bacharéis em Engenharia, com r = 0,9736573, r² = 0,9480084, p = 2,041 × 10⁻⁶, 2012 a 2021, séries do USDA e do National Center for Education Statistics; e a escala do garimpo, 25.237 variáveis e 636.906.169 cálculos, declarada pelo autor na página de metodologia. Não conferidos na fonte: queijo e mortes por enredamento em lençol (r = 0,947091) e filmes de Nicolas Cage e afogamentos em piscina (r = 0,666004) são da versão original de 2014, cuja página não foi possível reabrir; ambos são amplamente reproduzidos, o primeiro inclusive em periódico revisado por pares, citado abaixo.
- ANSCOMBE, F. J. Graphs in Statistical Analysis. The American Statistician, v. 27, n. 1, p. 17 a 21, 1973. Origem do quarteto citado na seção sobre a forma da relação.
- HILL, A. B. The Environment and Disease: Association or Causation? Proceedings of the Royal Society of Medicine, v. 58, p. 295 a 300, 1965. Origem dos pontos de vista que as sete perguntas adaptam para processo industrial.
- HRABAČ, P.; TRKULJA, V. Of cheese and bedsheets: some notes on correlation. Croatian Medical Journal, v. 61, n. 3, p. 293 a 295, 2020.
- KRULWICH, R. Nick Cage Movies vs. Drownings, and More Strange (but Spurious) Correlations. National Geographic, 11 de setembro de 2015.
O tratamento técnico de correlação, Pearson, Spearman, estratificação e paradoxo de Simpson, com exercícios resolvidos, está nos capítulos 16 e 37 da apostila Estatística Aplicada à Engenharia de Processos e à Qualidade, que é obra paga da FX. Nada neste artigo depende dela para ser entendido.
Perguntas frequentes
Qual a diferença entre correlação e causalidade?
Correlação responde se duas variáveis costumam se mover juntas na observação. Causalidade responde se intervir deliberadamente numa delas provoca mudança na outra. São perguntas diferentes: a primeira se responde olhando o histórico, a segunda exige um mecanismo que explique como X altera Y, e de preferência um experimento em que X foi mexido de propósito. Toda correlação é compatível com quatro estruturas, e apenas uma delas é causa direta.
O que é uma correlação espúria?
É uma associação estatística forte entre duas variáveis que não têm nenhuma ligação causal entre si. Ela aparece por acaso, principalmente quando se testam muitas combinações de séries, ou porque ambas as variáveis seguem uma tendência comum no tempo. O exemplo mais conhecido é o consumo de margarina nos Estados Unidos contra a taxa de divórcio no Maine, com r de 0,99 entre 2000 e 2009 e nenhum mecanismo plausível por trás.
O que significa o coeficiente de correlação r?
O coeficiente de Pearson resume em um número a força e a direção da associação linear entre duas variáveis. Ele vai de -1 a +1: perto de +1 elas sobem juntas, perto de -1 uma sobe enquanto a outra desce, e perto de 0 não há associação linear. Cuidado com a última leitura: r perto de zero não significa ausência de relação, porque uma relação em curva perfeita pode devolver exatamente zero.
r igual a 0,95 significa que X explica 95% de Y?
Não. A proporção de variação de Y associada a X é dada por r ao quadrado, não por r. Com r de 0,95, r² é 0,90, ou seja, 90%. A distorção cresce no meio da escala: r de 0,60, normalmente descrito como forte, corresponde a r² de 0,36, e os outros 64% vêm de outras fontes. E nenhum dos dois números diz qualquer coisa sobre causa: r² alto numa correlação espúria continua sendo coincidência bem ajustada.
O que é uma variável de confusão?
É uma terceira variável que influencia ao mesmo tempo as duas que aparecem correlacionadas, criando uma associação entre elas sem que uma cause a outra. O exemplo clássico é o consumo de sorvete e o número de ataques de tubarão, ambos empurrados pela temperatura. Na fábrica, o confundidor costuma ser a demanda, o mix de produto, o turno ou a máquina, e a forma de encontrá-lo é estratificar os dados por esses fatores antes de concluir.
Como provar que uma variável é a causa raiz de um defeito?
Reunindo evidência em várias frentes, porque não existe teste único. Verifique a sequência temporal, descreva o mecanismo físico que liga X a Y, estratifique por máquina, turno, lote e produto para ver se a relação sobrevive, procure relação dose-resposta, confirme que o padrão se repete em outro período ou equipamento e, quando for possível, provoque X de forma controlada num experimento planejado. Correlação isolada levanta a hipótese, não a confirma.